二进制文件格式揭秘:PNG、JPEG、MP4 们到底长什么样?
用十六进制视角解剖 PNG、JPEG、MP3、MP4、ZIP、PDF 等常见文件的二进制结构,总结二进制布局的通用规律(魔数、字节序、分块 TLV、索引表、帧同步、对齐与校验),并给出一套从零设计二进制格式的实用方法论。
- Mason Zheng
打开任意一个 .png 或 .mp4 文件,你看到的不过是一长串字节。但正是这串看似杂乱的字节,按照某种事先约定的结构排列,才让图片能被渲染、视频能被播放。这套"约定"就是二进制文件格式(Binary File Format)。
为什么不用人类可读的文本?因为对于图像、音视频这类数据,二进制更紧凑(不必把数字转成字符)、解析更快(按固定偏移直接读取)、表达更精确(可逐位控制)。代价是不能用记事本直接看懂——你需要知道"约定"。
本文就来揭开这层约定:先讲二进制格式的通用构件,再用十六进制视角逐一解剖常见格式,最后总结规律并给出一套自己设计格式的方法论。
一、二进制格式的通用构件
几乎所有二进制格式,都是用下面这几种"零件"搭出来的。
1.1 魔数(Magic Number / 文件签名)
文件开头几个固定字节,用来标识"我是什么格式"。操作系统和工具往往不靠扩展名、而靠魔数来判断文件类型。例如 PNG 永远以 89 50 4E 47 开头(50 4E 47 即 ASCII 的 “PNG”)。
1.2 字节序(Endianness)
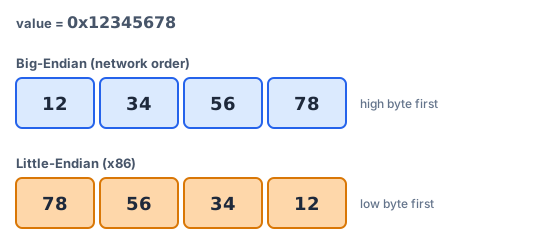
当一个多字节整数(如 4 字节的 0x12345678)写入文件时,存在两种排列:
- 大端序(Big-Endian):高位在前 →
12 34 56 78。也叫"网络字节序",PNG、JPEG、MP4 等采用。 - 小端序(Little-Endian):低位在前 →
78 56 34 12。x86 CPU 的原生顺序,WAV、ZIP、BMP 等采用。
读错字节序,数值就会完全错乱,因此格式必须明确规定用哪种。
1.3 头部 + 主体(Header + Body)
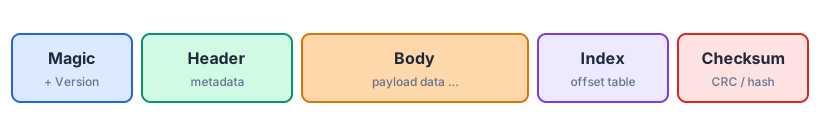
最经典的布局:开头一段定长头部描述元信息(尺寸、版本、各段偏移),后面跟着主体数据。读取时先解析头部,就知道后面怎么读。
1.4 定长字段与变长字段
- 定长字段:如"宽度占 4 字节",可直接按偏移量跳读,速度快。
- 变长字段:长度不固定(如一段文本、一张图)。这时必须有办法知道它多长——通常用长度前缀或结束标记。
1.5 TLV / 分块(Chunk / Box)
最强大的可扩展结构:把文件切成若干块,每块都自带描述。典型形式是 TLV(Type-Length-Value,类型-长度-值):
[类型][长度][数据...] [类型][长度][数据...] ...
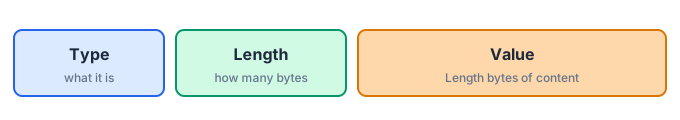
好处是:解析器遇到不认识的块,可以靠长度直接跳过,从而实现良好的向前兼容。PNG、MP4、RIFF 都是这种思路。
1.6 偏移表 / 索引(Offset Table)
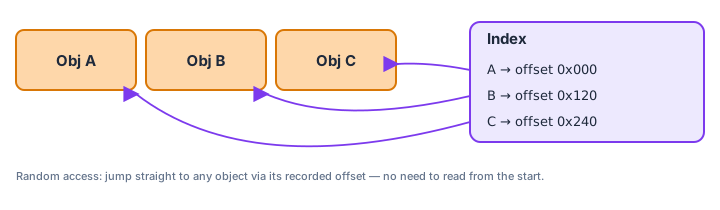
在文件某处放一张"目录",记录各个对象在文件中的字节偏移。这样可以随机访问——不必从头读到尾。PDF 的交叉引用表、ZIP 的中央目录都属于此类。
1.7 对齐与填充(Alignment & Padding)
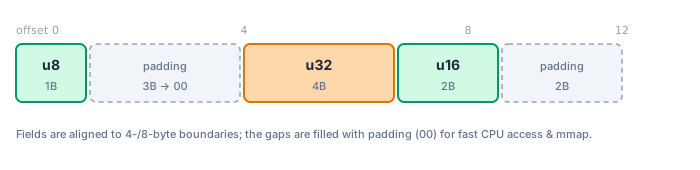
为了让 CPU 高效读取(或便于内存映射 mmap),字段常被对齐到 2、4、8 字节边界,不足处用 00 填充。
1.8 校验与版本
- 校验和(Checksum / CRC):用于检测数据是否损坏,如 PNG 每块尾部的 CRC-32。
- 版本号:写在头部,让新旧解析器能协商行为,是格式能长期演进的关键。
二、常见格式解剖(十六进制视角)
2.1 PNG —— 教科书级的分块设计
PNG 是理解"分块格式"的最佳范例。
(1) 8 字节签名:
89 50 4E 47 0D 0A 1A 0A
‰  P  N  G  \r \n ^Z \n
这 8 个字节设计得很巧:89 的高位可检测 7 位传输损坏,PNG 是标识,\r\n 与 \n 可检测换行符被错误转换,^Z(0x1A)让 DOS 下 type 命令提前停止。
(2) 之后是一连串 Chunk,每块结构固定:
| 字段 | 长度 | 说明 |
|---|---|---|
| Length | 4 字节(大端) | 数据区的字节数(不含本字段、类型、CRC) |
| Type | 4 字节 ASCII | 块类型,如 IHDR、IDAT、IEND |
| Data | Length 字节 | 块数据 |
| CRC | 4 字节 | 对 Type+Data 计算的 CRC-32 |
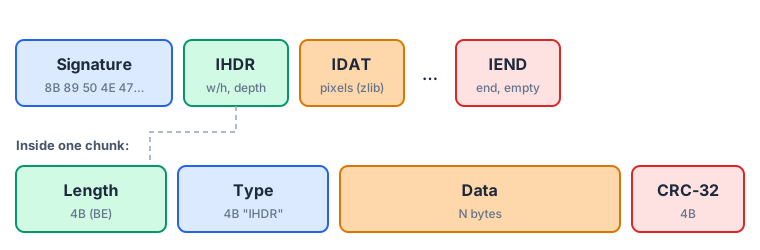
关键块:IHDR(图像头,含宽高、位深、颜色类型)→ IDAT(zlib 压缩的像素数据,可分多块)→ IEND(结束标记,数据为空)。
最妙的设计——块类型用大小写编码属性: 类型首字母大写表示"关键块(critical)",小写表示"辅助块(ancillary)"。解码器遇到不认识的辅助块可安全跳过——这正是优雅的向前兼容。
2.2 JPEG —— 标记(Marker)驱动
JPEG 用 FF 开头的标记来分段,大端序。
FF D8                  SOI  图像开始
FF E0 .. (JFIF header) APP0 应用段
FF DB .. (量化表)       DQT
FF C0 .. (帧信息)       SOF0 宽高、分量
FF C4 .. (霍夫曼表)     DHT
FF DA .. (扫描头)       SOS  之后是熵编码的压缩数据
...                     压缩数据
FF D9                  EOI  图像结束
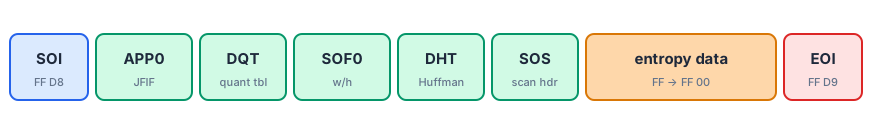
大多数标记后跟 2 字节大端长度。注意一个细节:压缩数据里若出现 FF,会被填充为 FF 00(字节填充 byte-stuffing),以免与标记混淆。
2.3 MP3 —— 无全局头的"帧同步"
MP3 没有统一头部,而是由一连串独立的**帧(frame)**组成,每帧 4 字节头以 11 个连续的 1 位(帧同步字,约 FF Ex)开头:
[可选 ID3v2 标签] [帧][帧][帧]...[帧] [可选 ID3v1 标签]
   "ID3"...          ↑每帧头含比特率/采样率      末尾128字节 "TAG"...
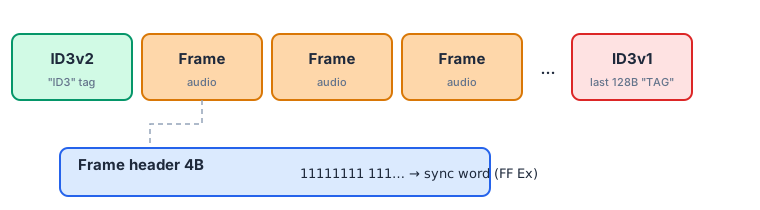
播放器靠"扫描帧同步字"来定位帧,因此 MP3 天然支持流式播放与任意位置续播(广播电台切进来也能立刻解码)。ID3 标签则用于存放歌名、歌手等元信息。
2.4 MP4 / ISO-BMFF —— 嵌套的"盒子(Box)"
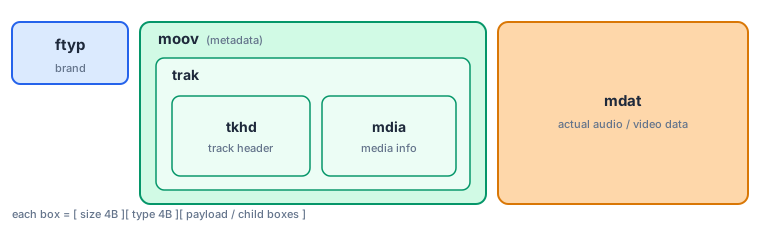
MP4 属于 ISO 基础媒体文件格式,由可嵌套的 **Box(也叫 Atom)**组成,大端序:
[4字节 size][4字节 type][数据/子box...]
size包含这 8 字节头本身;若size == 1,紧跟一个 64 位大尺寸字段(支持超大文件);若size == 0,表示一直到文件末尾。- 典型 box:
ftyp(文件类型/品牌,必须在最前)、moov(元数据,描述轨道、时长、索引)、mdat(实际音视频数据)。
box 可层层嵌套(moov 里含 trak,trak 里又含更多 box),形成一棵树。
2.5 RIFF / WAV —— 小端容器
WAV 基于 RIFF 容器(AVI、WebP 也是),小端序,本质也是 TLV:
"RIFF"[总长度]"WAVE" "fmt "[长度][采样率/声道...] "data"[长度][PCM 采样...]
2.6 ZIP —— 从尾部往前读
ZIP 的设计反直觉:关键索引在文件末尾。
[本地文件头 PK\03\04][文件1数据] [PK\03\04][文件2数据] ...
[中央目录 PK\01\02 ...每个文件一条]
[中央目录结束记录 EOCD  PK\05\06]   ← 在最末尾,记录中央目录的偏移
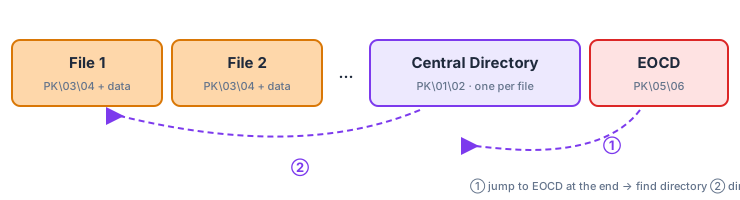
解析器先跳到文件末尾找 EOCD,读出中央目录位置,再据此定位每个文件。正因如此,ZIP 文件前面可以随意附加数据(自解压程序、其它格式),照样能被正确解压。
2.7 PDF —— 文本与二进制的混合体
PDF 很特别,它的骨架是 ASCII 文本,但内嵌二进制流,并且从文件尾部开始解析:
%PDF-1.7                  ← 头部,声明版本
12 0 obj << ... >>
stream ...(二进制)... endstream endobj   ← 间接对象,可含压缩流
...更多对象...
xref                       ← 交叉引用表:对象号 → 字节偏移
trailer << /Root 1 0 R /Size 13 >>
startxref
116544                     ← xref 表所在的字节偏移
%%EOF                      ← 文件结束
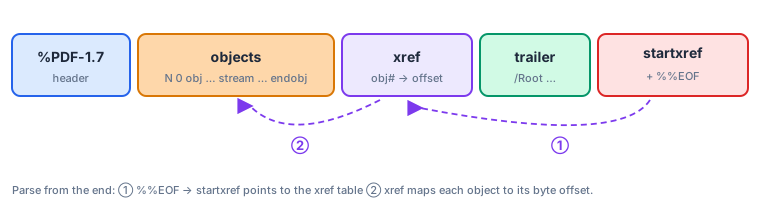
阅读器先找到末尾的 %%EOF 与 startxref,跳到 xref 表,再通过偏移随机访问任意对象。这种"索引表 + 间接引用"的设计,让 PDF 能支持增量更新(在文件尾追加新对象和新 xref 即可)。
2.8 魔数速查表
| 格式 | 起始字节(十六进制) | ASCII |
|---|---|---|
| PNG | 89 50 4E 47 0D 0A 1A 0A | .PNG.... |
| JPEG | FF D8 FF | —— |
| GIF | 47 49 46 38 | GIF8 |
25 50 44 46 | %PDF | |
| ZIP / docx / jar | 50 4B 03 04 | PK.. |
| MP3(ID3v2) | 49 44 33 | ID3 |
| MP4 | (偏移 4 处)66 74 79 70 | ftyp |
| WAV / AVI / WebP | 52 49 46 46 | RIFF |
| ELF 可执行文件 | 7F 45 4C 46 | .ELF |
| Java class | CA FE BA BE | —— |
想亲自验证?在终端用
xxd file.png | head或hexdump -C file.png | head就能看到上面这些字节。
三、二进制布局的通用规律
把上面的实例横向对比,会发现万变不离其宗的几条规律:
- 自描述:开头放魔数 + 版本号,让文件能"自报家门"。
- 头部 + 主体:先元信息后数据,几乎是默认范式。
- 分块 / TLV:用 Type-Length-Value 切块,配合"跳过未知块"实现可扩展与向前兼容(PNG、MP4、RIFF)。
- 索引 / 目录:用偏移表实现随机访问(PDF 的 xref、ZIP 的中央目录)。
- 帧同步:用固定同步字让数据流可在任意点切入(MP3)。
- 对齐与校验:对齐求性能,CRC 求完整性。
更宏观地看,存在两大设计哲学:
- 流式(Streaming):边读边处理,无需完整文件,适合网络传输与边下边播——PNG、MP4、MP3。
- 随机访问(Random-Access):靠尾部/内嵌索引按需跳读,适合大文件局部读取与增量更新——PDF、ZIP。
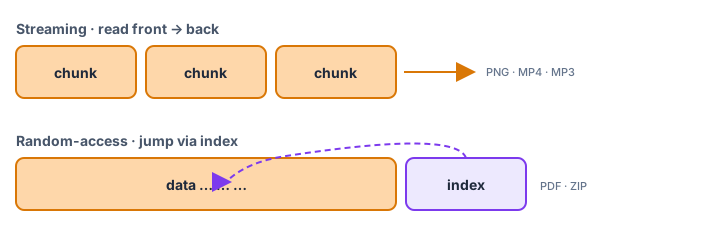
以及两大字节序阵营:大端(网络与多媒体:PNG/JPEG/MP4)与小端(x86 生态:WAV/ZIP/BMP)。
四、如何设计一个二进制格式
如果哪天你要为自己的项目设计一种文件格式,下面这套清单能帮你少踩坑。
① 开头放魔数 + 版本号。 让文件可被识别、可被未来的版本兼容。版本号是给"未来的你"留的后路。
② 选定字节序并写进规范。 没有特别理由就用大端(网络字节序)或直接复用现有约定,全文统一。
③ 万物皆长度前缀。 变长字段一律先写长度再写内容,避免解析时去"扫描结束符"——更快也更安全(防越界)。
④ 优先用 TLV / 分块结构。 它带来近乎免费的扩展性:新增功能就加新块,老解析器遇到不认识的块直接按长度跳过。可借鉴 PNG 的"关键/可忽略"标志位,区分"必须看懂"与"可选"的块。
⑤ 考虑对齐。 若希望用 mmap 直接映射结构体或追求读取性能,把字段对齐到 4/8 字节边界。
⑥ 加入完整性校验。 至少为关键区加 CRC32 或哈希,能及早发现损坏与篡改。
⑦ 预留字段。 头部留几个 reserved 字节填 0,为未来扩展留空间。
⑧ 优先复用成熟方案,别重复造轮子。 多数情况下你并不需要从零设计:
- 通用结构化数据 → Protocol Buffers、FlatBuffers、Cap’n Proto、CBOR、MessagePack;
- 需要容器/嵌套 → 直接基于 RIFF 或 ISO-BMFF 扩展。
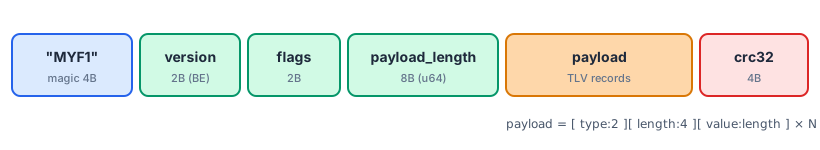
一个"玩具格式"的头部设计大致长这样:
偏移  长度  字段
0     4     magic = "MYF1"
4     2     version (u16, 大端)
6     2     flags
8     8     payload_length (u64, 大端)
16    ...   payload:一串 TLV 记录
            每条记录 = [type:2][length:4][value:length]
末尾  4     crc32(覆盖前面全部内容)
⑨ 写文档。 二进制格式没有自解释性,一份清晰的字节布局规范文档,价值等同于格式本身。
五、加密文件,也是一种二进制格式
理解了上面这些,再看"加密文件"就毫不神秘了——它同样是一段有约定的二进制布局。一个典型的加密文件大致是:
[魔数/版本][盐 salt][初始向量 IV/Nonce][密文 ciphertext...][认证标签 auth tag]
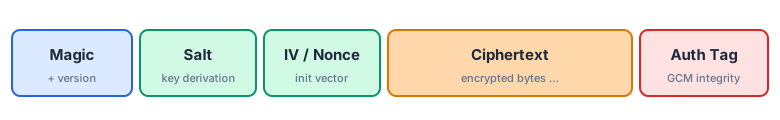
解密时,程序按这个布局把各部分切出来:用盐和你的口令派生出密钥,用 IV 初始化算法,再用认证标签校验密文未被篡改,最后还原明文。LocalFileEncrypt.com 用 AES-256-GCM 加密时产出的,正是这样一段自包含的二进制数据——它在你的浏览器本地完成,全程不上传,你可以用任何兼容工具自行解密(详见《我们如何加密你的数据》)。
总结
文件没有魔法,每一个 PNG、MP4、PDF 背后,都是一份"如何排列字节"的约定。掌握了魔数、字节序、头部、TLV 分块、索引表、帧同步、对齐与校验这几样通用构件,你就能读懂几乎任何二进制格式,也能在需要时设计出清晰、可扩展、经得起演进的自己的格式。下次再用 hexdump 打开一个文件,你看到的将不再是乱码,而是一套优雅的工程设计。